将现实物体扫描并整理成游戏引擎/具身引擎支持的、可参与交互及编辑的数字模型资产,一直以来是计算机图形学研究的重要方向。过去的工作已经在刚体层面的 Real2Sim 重建上取得了重大进展。但是仿真引擎中支持的交互物体不止有刚体。考虑到具身和游戏需求的 Real2Sim 输出的内容是渲染出的动画,我们重建出的资产也需要为这一点服务。
游戏引擎中的动画可以划分为这几类:刚体动画、骨骼动画、物理仿真动画(除此之外还有在游戏或现实中相对少见的顶点动画、2D帧动画、形变动画、粒子动画等,在此不做考虑)。现有的 4DGS 工作虽然用形变网络或升维的形式取得了较好的进展,但这种形式的资产可以类比顶点动画,并不太适用于编辑或交互,存储和在线计算成本也高于游戏的需求,因此将现在顶点动画级别的重建优化到骨骼动画/物理仿真动画是非常讲得通的工作。
我们这里主要关注骨骼动画级别的 4D 资产重建。从顶点动画到骨骼动画实际上是做了这样的假设:所有顶点的运动可以由少量的基函数线性表示,而这些基函数就对应现实中我们观察到的骨骼结构。因此这里将这类工作称为“结构感知的 Real2Sim 重建”。
我们希望的目标是用尽可能低的采集成本(仅一部手机或相机)和尽可能低的计算成本(仅一台普通 PC)重建出外观真实、结构清晰、且可编辑的骨骼动画资产,且人工需要的操作最好优化到只有采集部分,不需要后续人工参与处理。例如,玩家可以用自己的手机按指示“扫描”一遍自己,就可以上传至游戏中绑定动画预设作为自己的 avatar,理想情况下可以做到这样很酷的效果。
一般来说,这种采集成本意味着我们可以有某个状态的稠密观察(可以对场景扫描一圈),以补充我们对整个场景的信息认知,但对运动只有单视角的稀疏观察(只有单目视频可以用)。而对于具身应用来说,我们拥有的信息还有机械臂的 URDF、运动过程中的关节信息、以及大量良好标注的先验仿真数据集。从具身先验入手,这个问题可能会稍微好做一些。
并且我们希望我们的问题不是欠定的。例如稀疏 3DGS 重建类问题,大部分不可见视角依赖于生成模型的修补,这类方法虽然也有应用价值,但我们更希望能采集到足以恢复完整细节的信息,重建出高质量高保真的资产。
我们精读并梳理一些与这一目标相关的近期工作。
一. 骨骼动画级别的 Gaussian 重建与绑定
SC-GS: Sparse-Controlled Gaussian Splatting for Editable Dynamic Scenes (CVPR 2024)
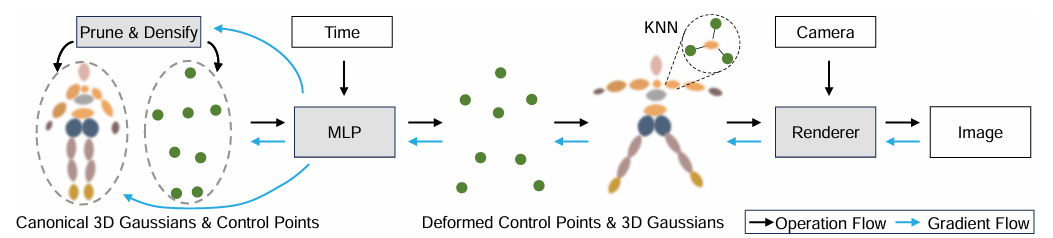
本文算是 4DGS 结构化假设的起点论文,在这之前的 baseline 是 Deformable 3DGS。这篇论文的细节意外的相当数学相当有趣。SC-GS的输入是一个单(动态)视角视频,输出一组带权控制点及其运动和 Gaussians,可以由此合成为运动的 4DGS。
本论文的场景形态为一个 canonical 3DGS 场景和约 512 个控制点,每个 Gaussian 选取在 canonical 3DGS 空间中选取最近的 4 个控制点以 RBF 权重(作为蒙皮权重)插值它们的变换得到每个时间的位置。整体的训练思路仍然为 coarse-to-fine 的可微渲染。训练流程为:
- 准备初值:输入视频帧和对应的相机参数,生成一组 SfM 点云,再从这组点云中生成一组带有大小、颜色、透明度属性的、稀疏的控制点代理点云,作为粗训练阶段的代理物体;生成一组初始的 Gaussians,作为粗训练后加入 Gaussian 的外观优化阶段的初值。
粗训练 10k steps:训练一个点云随时间 deform MLP(输入为位置、时间,输出仅位移,无旋转),直接将点云 splat 到屏幕上的结果作为被监督信号,用可微渲染优化 deform MLP 并对点云做 prune & densify。这里还用了 ARAP 能量监督点云局部尽可能刚性变形,减少过拟合。优化合适的运动后(7.5k step)用最远点采样得到 512 个控制点,再继续优化控制点。
- 这里 ARAP 形式的细节很值得学习。ARAP 能量为变换后邻域位置和在原始空间中对邻域求一个最贴合旋转位置的二次误差,即要求邻域变形保持刚性。在传统 Mesh 上的 ARAP 这里的邻域指的是曲面空间上的邻域,而这里的 Gaussians 是没有明确的曲面结构的。如果简单地把邻域换成 canonical space 的 近邻点,会出现这样的问题:在 canonical space 中紧贴的两个物体可能会在后续帧分开,ARAP 能量反而会导致紧贴处“分开”困难。
- 因此本文的邻域定义为,采样点云在 个时间的位置,拼接成一个 向量,在这个空间中的近邻点定义为受 ARAP 能量约束的邻域。即,邻域要求在视频的大部分时候都紧贴在一起,而不是仅仅在 canonical space 中紧贴。
- ARAP 的权重随训练步数降低,负责在早期先把粗运动结构拉正,后续再由渲染损失拟合细节。
- 最远点采样的选择颇有一些大数据算法的趣味,把稀疏的点云再做一次类似 clustering 的操作得到一些最有代表性的控制点。
Gaussian Warm-up 3k steps:冻结控制点参数及 deform MLP,启用外观 Gaussians,按 RBF 权重插值控制点的变换得到每个时间的 Gaussians 位置,对每帧做可微渲染,优化 Gaussians 的外观属性(位置、颜色、透明度)。
- 这里的 RBF deform 和 USTC CG 作业 2 的 image warping 基本是一致的,联想在一起就很容易知道这里采取的变换形式。
- RBF半径(作用强度)在这一阶段以及之前一直是等权的。
- 联合精细优化 训练至 40k~80k steps:开放外观 Gaussian、控制点参数、deform MLP 的训练,联合优化所有参数,Loss 为渲染损失 + ARAP 能量,还有可选的光流监督和 mask 监督。
论文的实验验证了:SC-GS 的运动空间低维假设对 PSNR 贡献了很多;ARAP 能量的数值提升贡献约 0.690dB PSNR,主要在避免一些明显错误的局部运动;反光物体上的优化效果相对不那么有优势;SC-GS 由于 MLP 查询只需要在控制点上进行、优化掉了这个大瓶颈,因此能达到比 4DGS 高一倍的 FPS,和 3DGS 有一样的实时渲染效率,800*800 的画面在 3090 上能达到 295.4 FPS。
总之为结构化的 4DGS 重建提供了一个很好的初始形式。本文提到的主要局限性是对相机位姿误差敏感、覆盖角度有限时会过拟合、仅验证了中等幅度的运动。
RigGS: Rigging of 3D Gaussians for Modeling Articulated Objects in Videos (CVPR 2025)
SV-GS: Sparse View 4D Reconstruction with Skeleton-Driven Gaussian Splatting (CVPR 2026)
二. 基于预训练模型的场景结构预测
Articulate-Anything: Automatic Modeling of Articulated Objects via a Vision-Language Foundation Model (ICLR 2025)
三. 生成修补式稀疏重建
四. 前馈 3DGS 系列工作跟进
References
- [1] Y.-H. Huang, Y.-T. Sun, Z. Yang, X. Lyu, Y.-P. Cao, and X. Qi, “SC-GS: Sparse-Controlled Gaussian Splatting for Editable Dynamic Scenes,” arXiv preprint arXiv:2312.14937, 2023.
- [2] Y. Yao, Z. Deng, and J. Hou, “RigGS: Rigging of 3D Gaussians for Modeling Articulated Objects in Videos,” in CVPR, 2025.
- [3] J.-J. Chao and V. Isler, “SV-GS: Sparse View 4D Reconstruction with Skeleton-Driven Gaussian Splatting.” [Online]. Available: https://arxiv.org/abs/2601.00285
- [4] L. Le et al., “Articulate-Anything: Automatic Modeling of Articulated Objects via a Vision-Language Foundation Model,” arXiv preprint arXiv:2410.13882, 2024.